Causa: la sesión de la Shell no tiene la API key cargada. Pasa al abrir una Shell nueva en Proxmox.
Arreglo: exportarla en esa sesión con export LUDUS_API_KEY='<tu-api-key>', o guardarla con el comando ludus apikey. La clave la muestra ludus-install-status al terminar la instalación. Ojo: ejecutarlo otra vez recrea la clave y la anterior deja de funcionar, así que guárdala la primera vez. No la pegues en chats ni en repositorios.
GOAD se detiene antes de crear las VMs
Causa: Ludus necesita la plantilla Debian 13 para el router y no estaba construida.
Arreglo:ludus templates build -n debian-13-x64-server-template y reanudar con la misma instancia (-i).
La sesión SSH se cae y GOAD queda a medias
Causa: el proceso de Ansible muere con la sesión.
Arreglo: lanzarlo con nohup y un fichero de registro, y reanudar con -i <ID-de-instancia> sin crear otro laboratorio. Ver GOAD-Light.
SQL Server 2019 da 404
Causa: la URL de descarga del instalador de SQL Server Express 2019 que trae el rol mssql ya no existe.
Arreglo: cambiar la URL en ansible/roles/mssql/defaults/main.yml por el enlace oficial de Microsoft (https://go.microsoft.com/fwlink/?linkid=866658) y comprobar que descarga el ejecutable.
SSMS se queda colgado en castelblack
Causa: el rol descarga un instalador pequeño de SSMS que ahora apunta al canal de SSMS 22 y se cuelga tras detectar VS y .NET. Además, si lo lanzas por WinRM, el instalador muere al cerrarse la sesión.
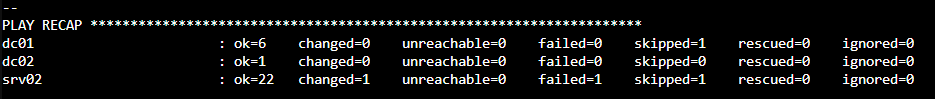
Resumen de Ansible con un fallo en srv02 (failed=1) durante la instalación de SSMS
Arreglo:
Descargar el instalador completo de SSMS 18.12.1 (unos 677 MB) y dejarlo en la máquina
Reiniciar para limpiar el reinicio pendiente
Ejecutarlo como tarea programada con SYSTEM, no desde la sesión WinRM, con /install /quiet /norestart
Reanudar los playbooks restantes: servers.yml, security.yml y vulnerabilities.yml
Después de eso, GOAD terminó con failed=0 en las tres máquinas.
Elastic se queda sin memoria
Causa: con 8 GB, Elasticsearch, Kibana y Fleet arrancan muy justos y Kibana deja de responder durante el arranque.
Arreglo: subir la VM a 12 GB de RAM, añadir 4 GB de swap y relanzar solo el rol de Elastic. Aun así queda ajustado, con unos 9 GB en uso.
Los eventos salen con 6 horas de desfase
Causa: las tres Windows tenían zona horaria Eastern (UTC-4), pero Proxmox les pasa la hora local de Madrid. Windows calculaba un UTC +6 h. Además, DC01 tomaba la hora de "Local CMOS Clock" y propagaba el error a DC02 y SRV02.
Arreglo:
Poner la zona correcta (Romance Standard Time) en las tres VMs
Apuntar DC01 a un NTP externo, con w32time configurado como fuente fiable
DC02 sincroniza con el dominio y SRV02 con DC01
Los eventos anteriores al arreglo se quedan desplazados. Para verlos limpios, usa el selector de tiempo en Last 15 minutes, que termina en "ahora" y excluye los eventos con fecha futura.
Proxmox se reinició y el laboratorio no responde
Causa: las VMs de GOAD no arrancan solas con el host.
Arreglo: encender el rango con Ludus (revisa ludus power --help) o desde Proxmox, y comprobar que los agentes de Elastic vuelven a estar Healthy en Fleet.
Instalar NetExec en WSL falla
Causa: faltan las herramientas de compilación (netifaces necesita C y arc4/aardwolf necesitan Rust).